AI 语音交互技术实践系列 02|知识检索:如何平衡检索效果、时延与成本
AI 语音交互要给出准确、及时的回答,离不开对信息的有效检索。个人记忆与垂类知识的检索方式有什么区别?面对不同规模的资料,又该如何设计检索与索引?
例如:“我上次说想去哪里旅行?”这类问题需要调用个人记忆;而“这款设备怎样离线配网?”则需要垂类知识。前者通常从少量个人文本里寻找线索,后者则可能跨越大量的文档、表格与图片。因此,检索设计首先要看资料类型与候选范围,再决定数据怎样整理、索引如何建设,以及分数能否支持业务判断。
核心判断:个人记忆与垂类知识库应分开设计;数据建设决定证据能否被理解,索引建设决定以多少资源把证据找回来;分数用于业务决策前,必须先进行验证与校准。
本篇主要探讨如何区分个人记忆与垂类资料,并结合高级 RAG、容量估算和模拟配置,比较检索质量、时延与成本。
Chapter 01
个人记忆与垂类知识库,先分清资料与范围
用户提出问题后,系统首先需要进行路由判断,并根据身份、时间、领域、型号、版本与权限等条件过滤资料。
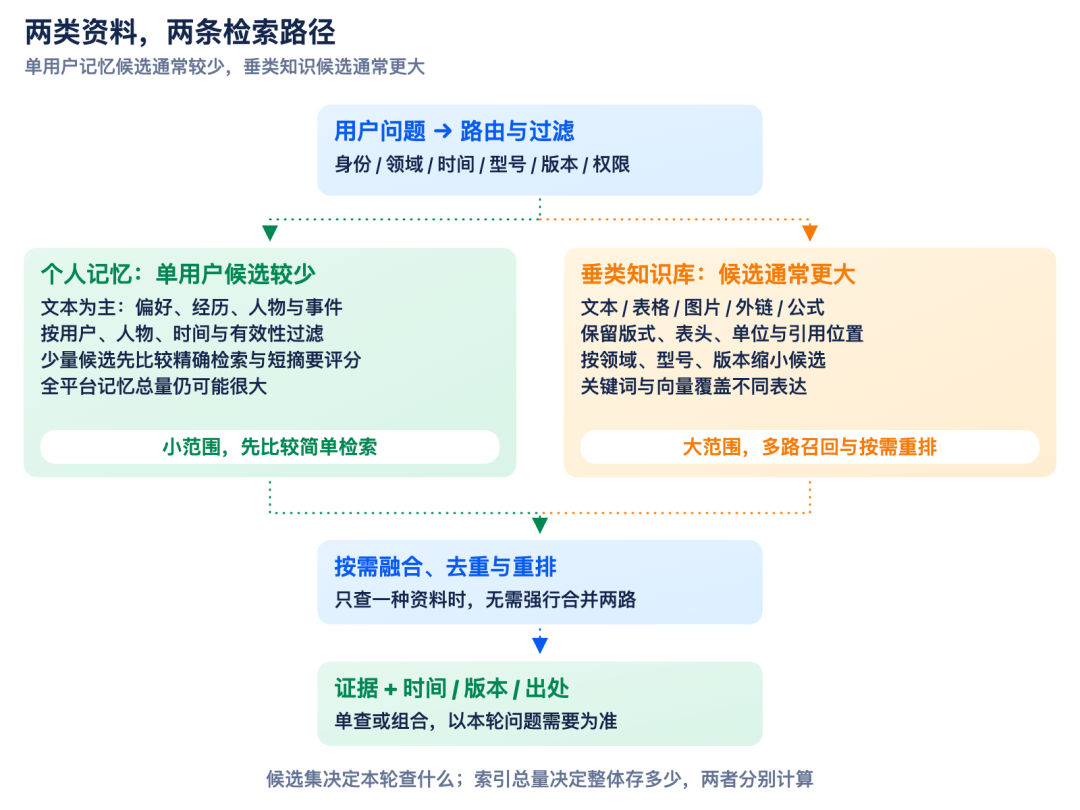
图 1 · 两类资料,两条检索路径
个人记忆回答的是“这个用户是谁、经历过什么、偏好什么”,而垂类知识库回答的是“这个领域、产品或流程有什么可靠依据”。大部分情况下,单用户个人记忆的候选范围较小,垂类知识库的候选范围较大;前者以文本为主,后者通常包含文本、表格、图片、网页外链、公式及其版面关系。
图 1 沿用了“两类资料、两条路径”的组织方式。实际检索时,系统可以根据问题只查询其中一种资料,也可以分别检索后组合证据,并非每次请求都必须经过两条检索路径。
需要注意的是,个人记忆候选较小,指的是单用户本轮候选集;多用户记忆合计后的索引总量仍可能很大。候选集决定一次请求查什么,索引总量决定整体存多少,两者需要分别计算。
Chapter 02
高级 RAG:从资料建设到证据驱动回答
以一个虚构的 A1 设备 E03 故障问题为例,可以看到高级 RAG 如何从资料处理逐步走向证据驱动回答。
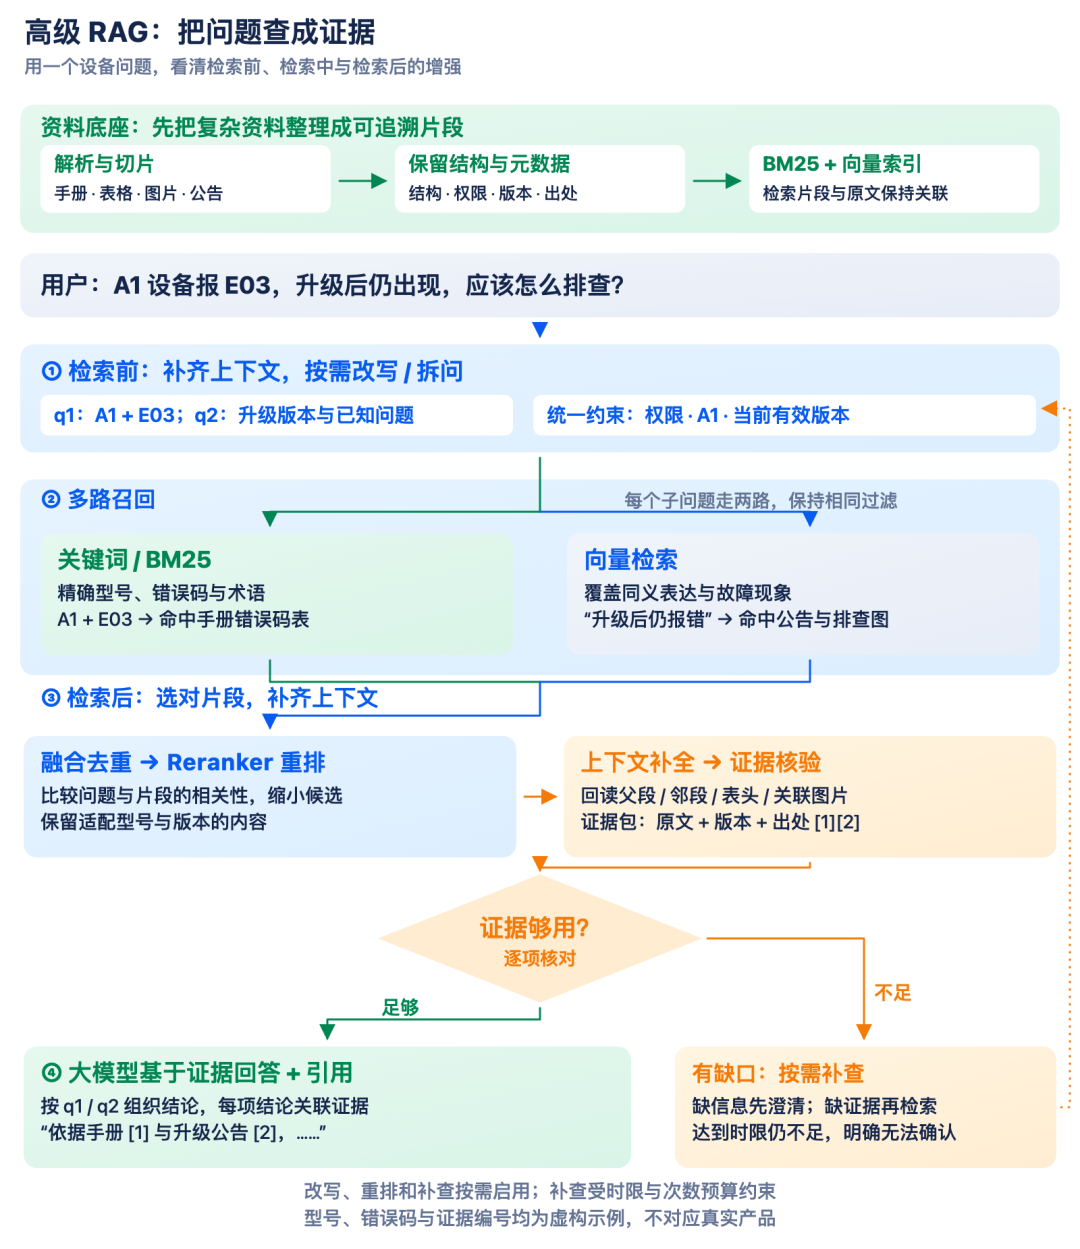
图 2 · 高级 RAG:从一个问题到可引用证据;案例为示意
高级 RAG 的增强主要发生在检索前、检索中和检索后。
首先离线解析资料并保留结构和元数据;在线补齐上下文、改写并拆分问题,同时施加相同的权限与版本过滤;接着通过 BM25 和向量进行并行召回;然后进行融合去重、按需 Reranker 重排、回读父段邻段表头与图片;最后核验证据,若足够则带引用回答,不足则限次补查或澄清。其中,OpenSearch 混合检索对应多路召回与融合,而拆问、后续重排和证据核验则由应用根据需求进行组织。
Chapter 03
数据与索引一起设计,平衡内存、时延与效果
以下通过两组模拟规模和 HNSW 容量估算,分析不同数据量、向量维度和索引参数对存储资源的影响。
图 3 · 数据量、向量与 OpenSearch 参数的容量账;模拟规模与公式估算
设计时应先确定数据量与本轮候选范围,再选择向量和索引参数。个人记忆按画像、事件、实体进行整理,结合时效与遗忘机制缩小范围;垂类资料则先保留表头、图片关联、公式条件和出处,再进行切片和向量化。切片与重叠会增加向量条数N,而去重和结构保留同样会影响容量与召回效果。
图里的内存差值,怎样算
图 3 中的 2 万条和 200 万条是两组模拟索引总量,均按一条记录对应一条向量来计算。未量化 float32 HNSW 的单份向量与图索引估算为C ≈ 1.1 × (4 × d + 8 × m) × N字节;d是维度,m是图连接参数。图中 byte 对照使用对应估算式,将每维 4 字节换成 1 字节。
以 200 万条为例:2048 降至 1024 维,估算减少9.01 GB;1024 维下把m从 16 增至 32,增加约0.28 GB。高维时向量本体占比大,但m对召回和遍历仍有影响。改用 byte 后约为2.53 GB,但需要验证量化损失;增加一份副本会使相关集群合计容量从9.29 GB增至18.59 GB。多主分片可以分摊数据,不再乘完整N。
以上计算按十进制 MB/GB,仅估算向量与图结构,不代表整机 RAM 或完整磁盘用量;正文、BM25、JVM、页缓存、段开销、重评分数据和运行余量需要另行计算。ef_search不直接乘入容量公式,它通过查询工作量来影响时延。
几个核心配置,各自调什么
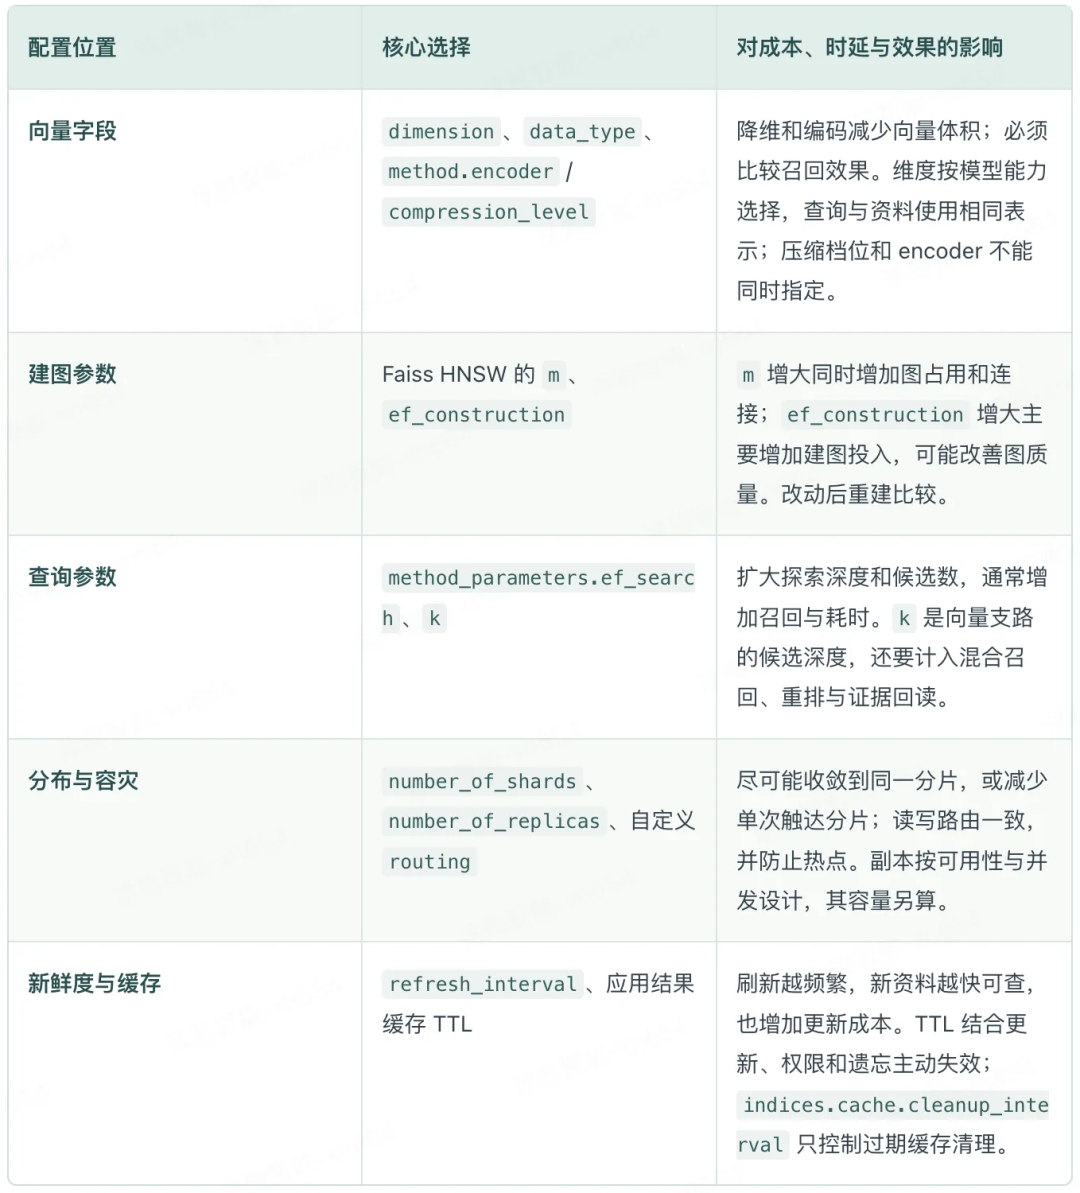
内存占用与查询时延密切相关。索引工作集能否保留在内存或页缓存中,会直接改变访存与 I/O 表现。实际评估时,还需要综合考虑 CPU、并发和段数量。
用两组模拟规模,给参数一个起点
以下是待评测的配置示例,并非推荐的最优值或实测成绩。建议统一先用 Faiss HNSW、float32、in_memory建立质量基线,然后逐项进行比较,避免同时改动所有参数。
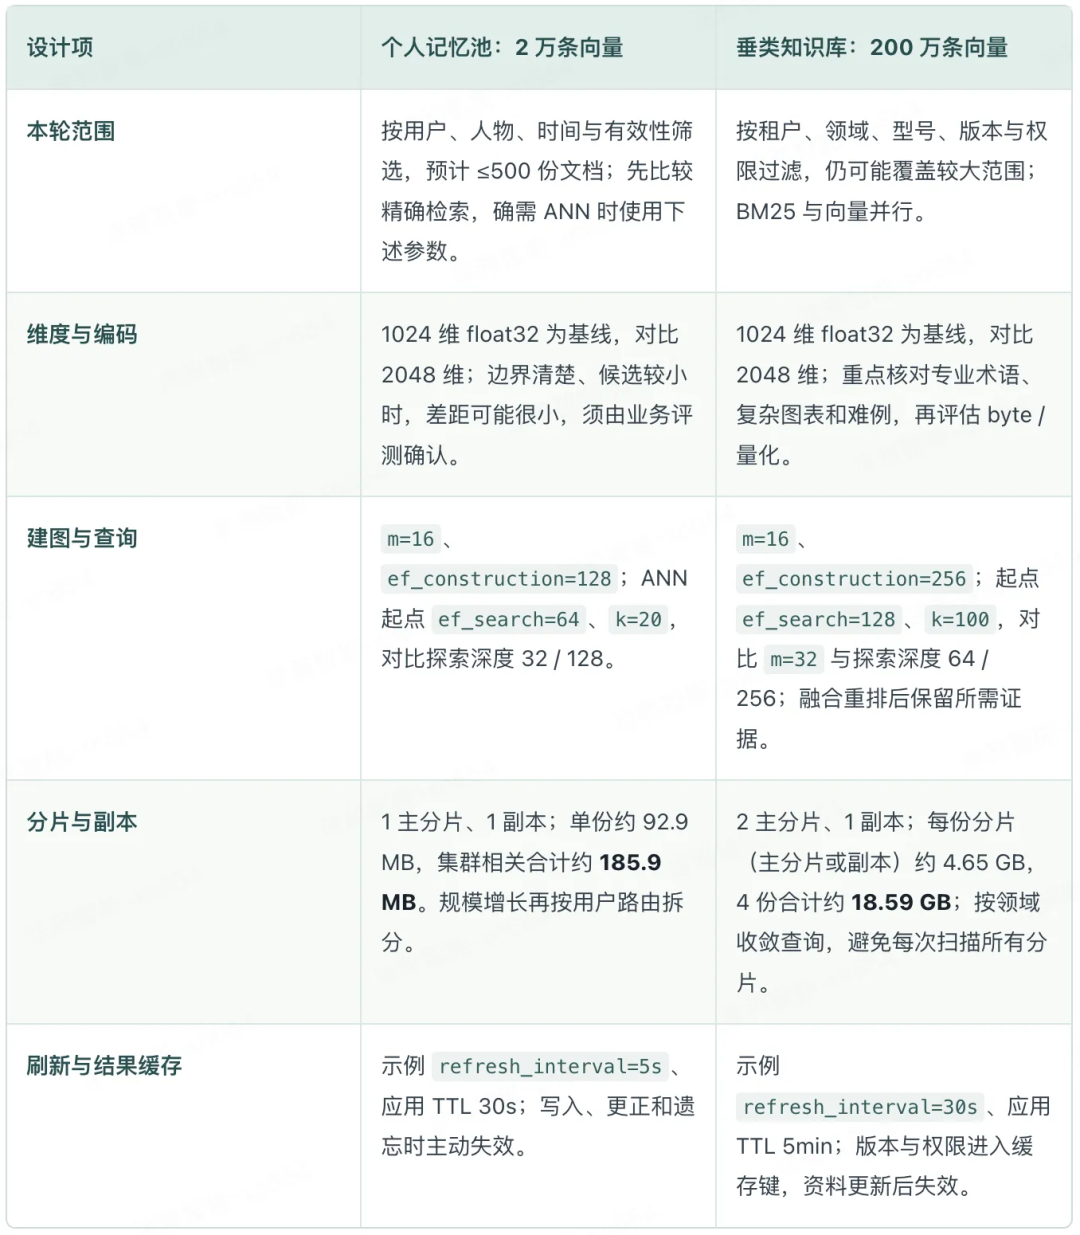
≤500 指本轮候选文档,并非全平台总量或最终返回数;继续切片时还要另算向量条数。维度不要一味追求越大越好。若 1024 与 2048 维在自有样本上的准确率、证据质量接近,可以优先选择较低维度以减小容量与访存。叠加路由、建图、查询和缓存调优后,其实际收益应按目标并发下的端到端结果来确认。对比时需同时记录召回质量、证据可用率、p95 / p99、实际驻留内存与费用。
冷热分层:节省热资源,接受冷查询代价
OpenSearch 可通过 ISM 与节点属性将索引分配到冷热层:高频资料存放在高性能节点上,低频资料迁移到低成本节点,从而减少昂贵的热资源占用;其代价是冷查询速度更慢,且迁移与跨层检索更加复杂。冷热划分与迁移条件需由业务自行设计。
向量还可采用on_disk压缩检索、磁盘重评分,或者通过 mmap 按需访问,以减轻全量常驻内存的压力,其代价是产生量化误差或更多 I/O。这些机制可与冷热分层配合,整机 RAM 收益需实测,参数按引擎支持范围选择。
前述 OpenSearch 参数主要用于自建索引方案。对于希望直接接入记忆与知识库的应用,也可以使用涂鸦开发者平台(https://platform.tuya.com)提供的能力,先配置记忆规则与资料库,再验证业务召回质量和响应时延。
相关能力介绍文档:https://developer.tuya.com/cn/docs/iot/agent?id=Kdxnn04ancnc8
Chapter 04
分数能排序,不等于概率已校准
得分达到0.9,并不等于有 90% 的把握答对。归一化只是把不同来源的分数换到同一把尺子上,方便进行排序;而置信度校准则是检查这些分数是否真的“说得准”。
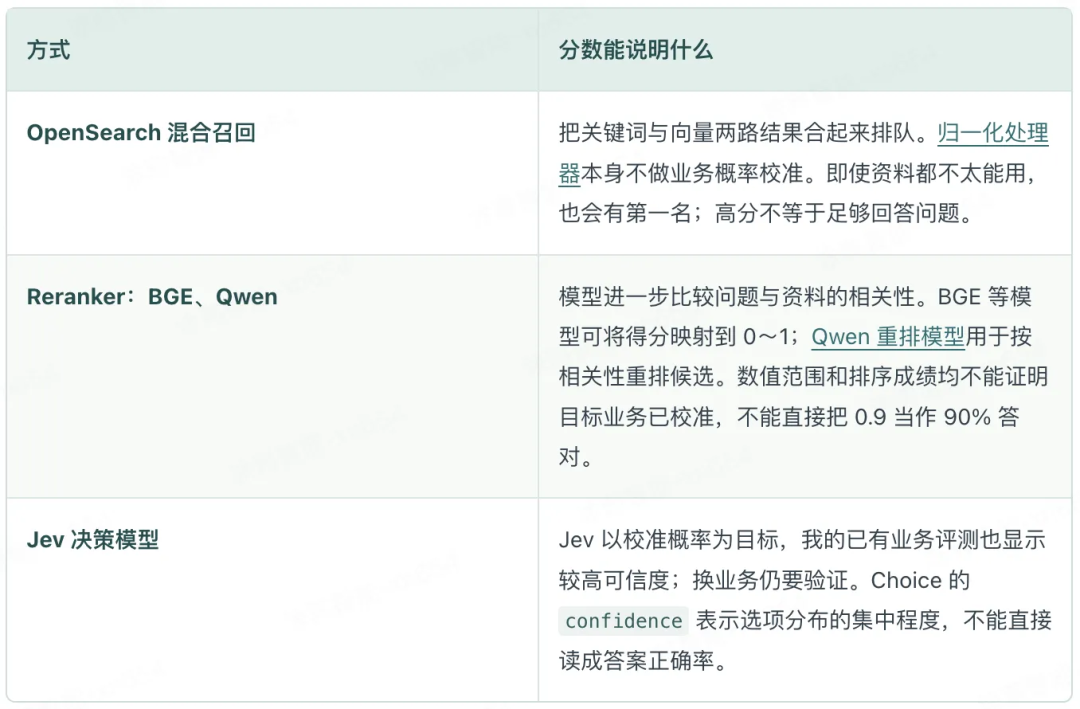
怎么验证?比如,要判断“这份资料是否足够回答问题”,可以取 100 份预测概率都在 0.8 附近的资料,由人工进行核对。如果约有 80 份确实足够,说明这个概率在这批样本上比较靠谱;如果只有 50 份,则说明模型过于自信。(这是举例,不是模型实测结果。)
建议先拿自己的业务样本进行核对,再用分数做业务判断。首先要界定清楚判断的目标是“相关”、“足够回答”还是“最终答对”,然后使用未参与调参的样本,检查高分样本里还会错多少、设定门槛后能处理多少请求。当模型或资料发生变化时,需要重新检查。未经验证的分数,只能留在检索层用于筛选和排序,不作为“事实可信度”交给大模型。
最后总结:
先按资料与候选范围选择检索路径,再联合评估向量、索引和缓存;以质量为前提平衡时延与成本,业务分数最后验证校准。
证据进入模型后,还要管理每次重复读取的规则、工具定义和对话历史,下一篇将继续介绍模型上下文:提示词调优、KV Cache 与历史压缩。
- AI 语音交互技术实践系列 02|知识检索:如何平衡检索效果、时延与成本
- 别再把单相曲线外推到含气工况:变转速燃油增压泵的含气性能为何会“分段塌陷”
- Xilinx I2C协议重点知识介绍
- I²C从设备掉电后,整条总线通信异常
- 永嘉微电VK16K33AQ 3.0‑5.5V宽压大电流LED驱动高亮数显驱动芯片
- 汽车 EPS 电动助力转向角度传感器选型:MT6701CT 深度剖析
- 沐曦股份GPU产品正式合入RLinf官方主线
- 光电检测的“眼睛”:一文拆解佰鸿 BPT-BP0934 红外光敏三极管
- 用超声波物理锁定鱼群,普联威给探鱼器装了一双“水下眼睛”
- Omdia:2026年第三季度全球智能手机市场下滑20%,内存危机重塑竞争格局
- 蓝牙模块选型指南:低功耗、双模、音频与车载方案对比
- PCB小批量打样怎么减少返工?Gerber、孔结构和阻抗资料交付清单
- 抒微Surertech受邀参展首届空天科技博览会(南通)
- 变焦视觉位移监测仪如何实现多断面位移监测?
- 常州工学院采购南京大展的DZDR-S导热系数测定仪
- CW32COM端口号可视化集线器——硬件详解